Latencia en México: benchmark de conectividad para empresas
Latencia en México: aprende a medir RTT, jitter y pérdida; compara proveedores con Smartnett y exige acuerdos SLA reales. Acción: mide RTT y exige <50 ms.
Benchmarking de Latencia en México 2025: La Batalla por la Eficiencia Empresarial
Un director de TI en Guadalajara revisa el tercer ticket de la semana: las transacciones del ERP tardan 4 segundos en confirmarse cuando el estándar interno exige menos de 1. El proveedor de conectividad reporta "disponibilidad del 99.5%" y asegura que todo está en orden. El problema es que la disponibilidad no mide lo que realmente afecta la operación: la latencia, el jitter y la pérdida de paquetes. En 2025, con aplicaciones críticas en la nube, videollamadas constantes y sistemas transaccionales en tiempo real, la latencia se convirtió en la métrica que separa a las empresas que operan con fluidez de las que sufren cuellos de botella invisibles. Este artículo explica qué es realmente el benchmarking de latencia, cómo interpretarlo y qué exigir a un proveedor de conectividad empresarial en México.
¿Qué es la latencia y por qué el benchmarking importa?
La latencia es el tiempo que tarda un paquete de datos en viajar desde el origen hasta el destino y regresar (round-trip time, RTT), medido en milisegundos (ms). No debe confundirse con el ancho de banda: una conexión de 1 Gbps puede tener latencia alta si la ruta física es larga, si hay demasiados saltos de red (hops) o si el proveedor no gestiona la calidad de servicio (QoS).
El benchmarking de latencia consiste en medir, comparar y documentar de forma sistemática estos tiempos entre distintos proveedores, rutas y horarios, para tomar decisiones informadas. No es un ejercicio académico: es la diferencia entre una videollamada fluida y una con cortes, entre una transacción bancaria confirmada en 200 ms y una que expira por timeout.
Los tres pilares que se miden junto con la latencia
Jitter: la variación de la latencia en el tiempo. Una conexión con 20 ms de latencia promedio pero jitter de 15 ms es peor para VoIP que una con 30 ms estables. El jitter es el enemigo silencioso de las videoconferencias y las llamadas VoIP, porque provoca eco, cortes de audio y desincronización de video.
Pérdida de paquetes (packet loss): el porcentaje de paquetes que nunca llegan a su destino. Por encima de 1% de pérdida, las aplicaciones en tiempo real empiezan a degradarse notablemente; por encima de 3%, se vuelven inutilizables para voz y video.
Jitter buffer y retransmisión: cuando hay pérdida o jitter alto, los protocolos como TCP retransmiten paquetes, lo que añade latencia percibida adicional y consume ancho de banda extra, generando un efecto en cascada difícil de diagnosticar si no se mide correctamente.
Cómo se mide la latencia en un contexto empresarial real
Medir latencia no es simplemente hacer un ping a un servidor público. Un benchmarking serio en 2025 involucra varias capas:
-
Latencia de última milla: el tramo entre las instalaciones del cliente y el primer punto de presencia (PoP) del proveedor. Aquí la tecnología de acceso —fibra óptica dedicada, microondas o cobre— define el piso de rendimiento posible.
-
Latencia de backbone: el trayecto dentro de la red del proveedor, entre PoPs, hasta llegar al punto de interconexión con internet o con el data center destino. Un backbone extenso y bien diseñado reduce los saltos innecesarios.
-
Latencia de peering e interconexión: el tiempo hasta llegar a los proveedores de contenido (AWS, Google Cloud, Microsoft Azure, Meta) o a otros carriers. Los acuerdos de peering directo con estos gigantes reducen drásticamente la latencia percibida por el usuario final.
-
Latencia de aplicación: el tiempo adicional que añade la infraestructura del cliente (firewalls, proxies, balanceadores). Aquí es donde el equipo de TI interno tiene control directo.
Herramientas y metodología recomendada
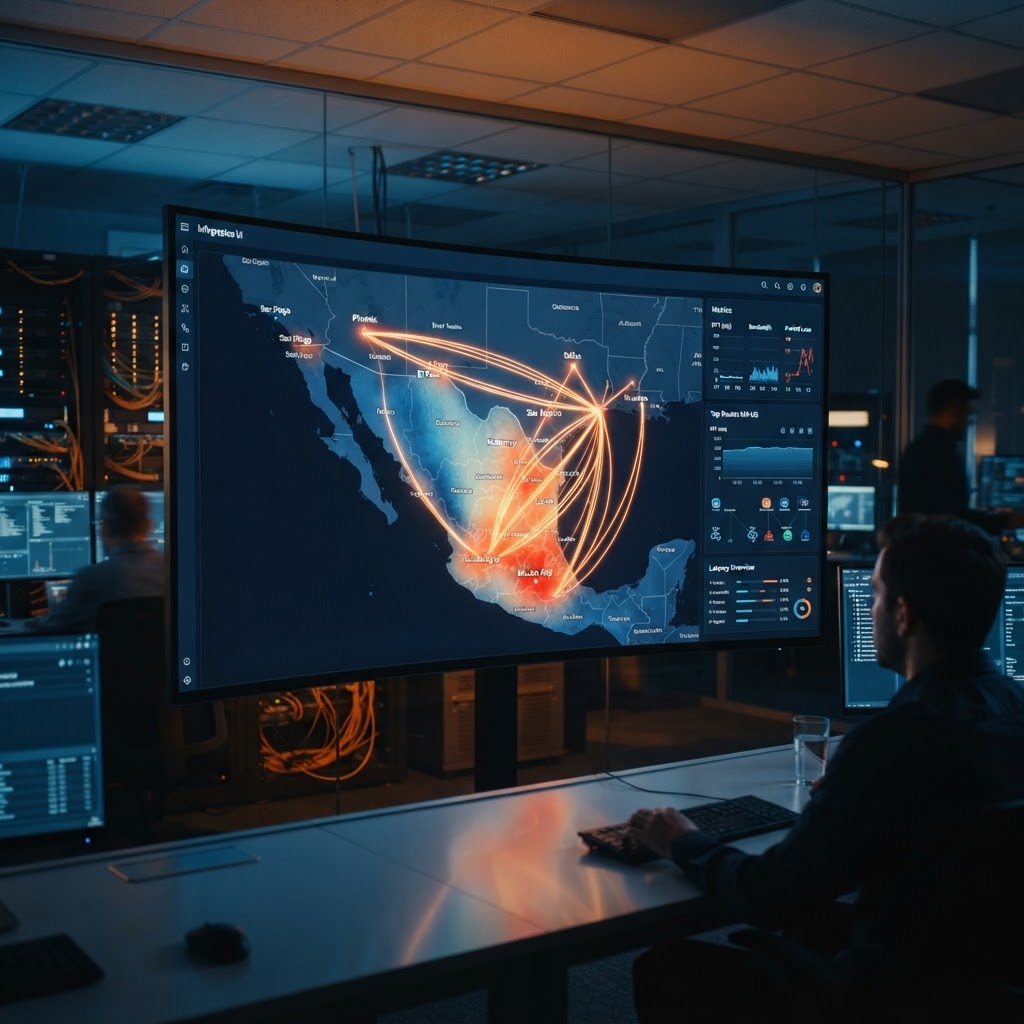
Para un benchmarking confiable se recomienda ejecutar pruebas continuas (no puntuales) usando protocolos ICMP y TCP en paralelo, durante al menos 30 días, en horarios pico y valle, hacia múltiples destinos (nube pública, sucursales, data center corporativo). Las métricas deben capturarse con herramientas de monitoreo activo tipo SNMP/NetFlow y correlacionarse con reportes del NOC del proveedor. Un solo ping matutino no representa el comportamiento real de la red bajo carga.
Por qué la latencia importa más que nunca para tu empresa
En 2020, la prioridad era simplemente "tener internet". En 2025, las cargas de trabajo cambiaron radicalmente: ERP en la nube, videoconferencia todo el día, respaldo en tiempo real, IoT industrial y aplicaciones de IA que requieren respuesta inmediata. Cada uno de estos casos tiene un umbral de latencia tolerable, y superarlo no es un inconveniente menor: es pérdida de productividad medible en pesos.
Un estudio operativo típico muestra que una latencia superior a 150 ms en aplicaciones transaccionales incrementa el tiempo de proceso por transacción entre 8% y 15%, lo que en un call center con miles de interacciones diarias se traduce en horas-hombre perdidas cada semana. En manufactura, la latencia alta en sistemas SCADA o MES puede retrasar la sincronización de líneas de producción, generando cuellos de botella físicos, no solo digitales.
Criterios técnicos de selección de proveedor
Elegir proveedor de conectividad empresarial exige ir más allá del precio por Mbps. Estos son los criterios que un director de TI experimentado debe exigir en cualquier propuesta:
Simetría y dedicación del enlace
Un enlace dedicado simétrico garantiza el mismo ancho de banda de subida y bajada, sin compartirlo con otros clientes (a diferencia de un enlace de banda ancha residencial o "best effort"). Esto es crítico para empresas que suben grandes volúmenes de datos: respaldos en la nube, videovigilancia centralizada, transferencia de archivos entre sucursales.
SLA con métricas explícitas, no solo disponibilidad
Un SLA (Service Level Agreement) que solo garantiza "99% de disponibilidad" es insuficiente. El SLA debe especificar:
- Latencia máxima garantizada por ruta.
- Jitter máximo tolerado.
- Porcentaje máximo de pérdida de paquetes.
- Tiempo de respuesta ante incidentes (MTTR, Mean Time To Repair).
- Penalizaciones económicas reales por incumplimiento, no solo créditos simbólicos.
Redundancia geográfica y diversidad de rutas
La redundancia no significa tener "dos cables". Significa tener rutas físicamente diversas (diferentes ductos, diferentes torres, diferentes proveedores de última milla) para que una falla en una ruta no derive en la caída total del servicio. También implica conmutación automática (failover) en milisegundos, no en minutos.
Cobertura del backbone y número de PoPs
Mientras más extenso y denso sea el backbone del proveedor, y mayor el número de puntos de presencia, más corto es el trayecto físico promedio entre el cliente y su destino final, lo que reduce la latencia estructural de forma permanente, no solo en condiciones ideales.
Casos de uso empresariales por industria
Banca y servicios financieros
Las transacciones interbancarias y los sistemas de core bancario requieren latencia inferior a 50 ms y disponibilidad cercana al 100%, porque cada segundo de retraso en autorización de pagos representa riesgo operativo y de cumplimiento regulatorio (CNBV). La redundancia geográfica no es opcional: es requisito de continuidad de negocio.
Manufactura e industria 4.0
Las líneas de producción con sensores IoT y sistemas SCADA dependen de latencia baja y estable para sincronizar procesos en tiempo real. Un jitter alto puede provocar desincronización entre estaciones de trabajo automatizadas, generando defectos de calidad o paros de línea.
Retail y comercio con múltiples sucursales
Los sistemas de punto de venta (POS) centralizados y el inventario en tiempo real requieren conectividad estable entre sucursales y el centro de datos corporativo. Una SD-WAN bien implementada permite priorizar el tráfico transaccional sobre el tráfico de navegación general en cada tienda.
Logística y cadena de suministro
El rastreo GPS en tiempo real, la gestión de flotas y los sistemas WMS (Warehouse Management System) requieren conectividad constante entre centros de distribución. La latencia alta retrasa la actualización de inventarios, afectando la precisión de las promesas de entrega.
Salud
Los sistemas de expedientes clínicos electrónicos, telemedicina e imagenología requieren transferencia de archivos pesados (estudios de imagen) con baja latencia y sin pérdida de paquetes, especialmente en hospitales que comparten información entre sucursales o con laboratorios externos.
Call centers y centros de contacto
La calidad de VoIP depende directamente de jitter y pérdida de paquetes. Un jitter superior a 30 ms genera degradación audible perceptible por el cliente final, afectando directamente los indicadores de satisfacción (CSAT) y el tiempo promedio de atención.
Gobierno y data centers
Los organismos gubernamentales que manejan trámites digitales y los data centers que alojan infraestructura crítica requieren SLA con penalizaciones reales y NOC disponible 24/7, dado que cualquier interrupción tiene impacto directo en servicios públicos o en clientes finales de terceros.
Errores comunes al elegir proveedor de conectividad
Enfocarse solo en el precio por Mbps: un enlace barato con alta latencia y sin SLA robusto termina costando más en pérdida de productividad que uno más caro pero confiable.
No exigir pruebas piloto: cualquier proveedor serio debe permitir un periodo de prueba con métricas reales de latencia, jitter y pérdida de paquetes antes de firmar contrato.
Ignorar la ruta física real: dos proveedores pueden ofrecer "fibra óptica" pero con trayectos físicos completamente distintos. Preguntar por el backbone y los PoPs específicos es indispensable.
Subestimar la redundancia: asumir que "nunca va a fallar" es el error más costoso. La pregunta correcta no es si habrá una falla, sino qué tan rápido el sistema se recupera cuando ocurra.
No monitorear después de la instalación: el benchmarking no termina al firmar el contrato. Debe ser un proceso continuo con dashboards y reportes periódicos del proveedor.
Preguntas frecuentes
¿Cuál es una latencia "aceptable" para una empresa en México?
Depende de la aplicación: para VoIP y videoconferencia se recomienda menos de 50 ms; para ERP y transacciones bancarias, menos de 100 ms; para navegación general, hasta 150 ms es tolerable. Por encima de estos umbrales, la experiencia del usuario y el rendimiento operativo se degradan de forma medible.
¿La fibra óptica siempre garantiza menor latencia que otras tecnologías?
En general sí, porque la luz viaja más rápido y con menos interferencia que las señales eléctricas o de radio. Sin embargo, la latencia final también depende del diseño del backbone, el número de saltos de red y la calidad del peering del proveedor, no solo del medio físico.
¿Qué diferencia hay entre disponibilidad (uptime) y calidad de latencia?
La disponibilidad mide si el servicio está activo o caído; la latencia mide qué tan rápido viajan los datos mientras el servicio está activo. Un enlace puede tener 99.9% de disponibilidad y aun así tener latencia inconsistente que afecta aplicaciones críticas en tiempo real.
¿Cómo puedo verificar si mi proveedor actual cumple realmente el SLA prometido?
Solicita reportes históricos de latencia, jitter y pérdida de paquetes generados por su NOC, e instala herramientas de monitoreo independientes (como sondas SNMP propias) para comparar. Si el proveedor no puede proporcionar datos granulares por ruta, es una señal de alerta.
¿SD-WAN elimina por completo los problemas de latencia?
No los elimina, pero los mitiga significativamente al seleccionar dinámicamente la mejor ruta disponible entre múltiples enlaces y priorizar tráfico crítico mediante QoS. Sigue siendo indispensable contar con enlaces de acceso de buena calidad como base.
Cómo Smartnett ayuda
Backbone propio de 53,100 km y más de 220 PoPs: esta infraestructura reduce el número de saltos físicos necesarios para llegar a los principales puntos de interconexión y nubes públicas en México, disminuyendo la latencia estructural de forma consistente, no solo en condiciones ideales de laboratorio.
SLA de 99.999% con métricas explícitas: Smartnett no solo garantiza disponibilidad, sino que documenta latencia, jitter y pérdida de paquetes por ruta, con penalizaciones reales ante incumplimiento, dando al equipo de TI datos concretos para exigir cumplimiento.
Redundancia real con conmutación automática: las rutas diversas y los mecanismos de failover en milisegundos reducen el riesgo de que una falla física se traduzca en interrupción del negocio, algo especialmente crítico para banca, manufactura y data centers.
NOC 24/7/365 e instalación en 96 horas: el monitoreo continuo permite detectar degradación de latencia antes de que afecte la operación del cliente, mientras que la instalación acelerada reduce el tiempo de exposición a proveedores insuficientes durante procesos de migración, con planes desde 300 Mbps hasta 10 Gbps simétricos según el tamaño de la operación.
Conclusión
La latencia dejó de ser un dato técnico secundario para convertirse en un indicador directo de eficiencia empresarial en 2025. Un director de TI que quiera tomar decisiones informadas debe:
- Exigir a cualquier proveedor métricas explícitas de latencia, jitter y pérdida de paquetes, no solo porcentaje de disponibilidad.
- Realizar benchmarking continuo de al menos 30 días antes de firmar contratos de largo plazo, incluyendo horarios pico.
- Priorizar tecnologías de acceso simétricas y dedicadas para cargas críticas como ERP, VoIP y sistemas transaccionales.
- Verificar la extensión real del backbone y el número de PoPs del proveedor, no solo el discurso comercial sobre "cobertura nacional".
- Implementar SD-WAN con QoS cuando existan múltiples sucursales, para priorizar tráfico crítico sobre navegación general y maximizar el uso de los enlaces disponibles.
La eficiencia empresarial en 2025 se construye milisegundo a milisegundo, y las empresas que lo entiendan antes tendrán una ventaja competitiva medible frente a las que sigan comprando conectividad basándose únicamente en el precio por Mbps.
Escrito por
Ing. Carla Estrada Vega
Network Engineering — Smartnett
Ingeniera en Sistemas Electrónicos (Tec de Monterrey). Especialista en fibra óptica y backbone de larga distancia. 10 años en despliegue de redes troncales y conectividad internacional México–EE. UU.