Cómo reducir la latencia en la red y evitar caídas
Cómo reducir la latencia en la red: guía para diagnosticar causas, optimizar rutas y proveedores. Smartnett recomienda medir RTT; solicita prueba de enlace hoy.

Estrategias para Minimizar la Latencia y las Caídas de Red
Un director de TI en México recibe, en promedio, más quejas por lentitud de red que por casi cualquier otro problema de infraestructura. Las videollamadas se congelan, las transacciones de punto de venta tardan segundos que se sienten como minutos, y las aplicaciones críticas en la nube responden con retrasos que erosionan la productividad. Detrás de estos síntomas hay dos culpables técnicos concretos: la latencia (el tiempo que tarda un paquete de datos en viajar de un punto a otro) y las caídas de red (interrupciones totales o parciales del servicio). Ambos problemas no son inevitables ni "parte del negocio": son el resultado de decisiones de arquitectura, proveedor y tecnología que pueden diagnosticarse y corregirse. Este artículo explica cómo funcionan estos fenómenos, qué los provoca realmente y qué estrategias técnicas debe evaluar un decisor de TI antes de firmar un contrato de conectividad empresarial.
¿Qué son la latencia y las caídas de red, y cómo funcionan?
Latencia: el tiempo de viaje de los datos
La latencia se mide en milisegundos (ms) y representa el tiempo que tarda un paquete de datos en ir desde el origen hasta el destino y, en muchos casos, regresar (round-trip time o RTT). Una latencia de 20 ms es prácticamente imperceptible para el usuario; una de 150 ms ya genera fricción notable en videoconferencias o aplicaciones transaccionales; por encima de 300 ms, la experiencia se degrada de forma severa.
La latencia se compone de varios factores:
- Latencia de propagación: el tiempo físico que tarda la señal en recorrer el medio (fibra óptica, cobre, radiofrecuencia). En fibra, la luz viaja a aproximadamente dos tercios de la velocidad de la luz en el vacío, lo que introduce un mínimo teórico inevitable.
- Latencia de procesamiento: el tiempo que tardan los routers, switches y firewalls en analizar y reenviar cada paquete.
- Latencia de cola (queuing): cuando hay congestión, los paquetes esperan en buffers antes de ser procesados, lo que añade retraso variable.
- Jitter: la variación en la latencia entre paquetes consecutivos. Un jitter alto (por ejemplo, superior a 30 ms) es tan dañino como la latencia misma para aplicaciones de voz y video, porque rompe la sincronía del flujo de datos.
Caídas de red: interrupciones del servicio
Una caída de red ocurre cuando el enlace pierde conectividad total (outage) o parcial (degradación con pérdida de paquetes, conocida como packet loss). El packet loss se mide en porcentaje: una pérdida superior al 1% ya es perceptible en llamadas VoIP, y superior al 5% vuelve inutilizables muchas aplicaciones en tiempo real. Las causas más comunes incluyen fallas en el último tramo de la red (last mile), cortes de fibra por obra civil, saturación de enlaces compartidos, fallas de energía en el sitio del cliente o del proveedor, y errores de configuración en el enrutamiento (BGP flapping, por ejemplo).
Por qué esto importa para tu empresa
La latencia y las caídas no son solo un problema de "experiencia de usuario": tienen impacto financiero directo y medible.
En sectores como banca y retail, cada minuto de inactividad en un sistema de autorización de pagos se traduce en transacciones perdidas y clientes frustrados. En manufactura, un ERP con latencia alta hacia el data center corporativo retrasa órdenes de producción y sincronización de inventarios entre planta y oficina central. En logística, los sistemas de rastreo GPS y gestión de flotas dependen de conectividad constante para optimizar rutas en tiempo real; una caída de 30 minutos puede significar decenas de entregas retrasadas.
Además, la latencia afecta directamente el rendimiento de aplicaciones modernas basadas en la nube (SaaS, ERP en la nube, VoIP, videoconferencia). Estas aplicaciones fueron diseñadas asumiendo conectividad estable y de baja latencia; cuando esa premisa falla, el software se vuelve, en la práctica, inservible, sin que haya un solo error visible en el código.
Criterios técnicos para seleccionar un proveedor
Tipo de enlace y medio físico
No todos los enlaces son iguales. Un enlace de fibra óptica dedicada ofrece baja latencia, ancho de banda simétrico y alta inmunidad a interferencias electromagnéticas. Un enlace de radio microondas es más rápido de desplegar pero está sujeto a condiciones climáticas y línea de vista. Un enlace satelital, aunque cubre zonas remotas, introduce latencias inherentes de 500-600 ms (satélites geoestacionarios) que lo hacen inviable para aplicaciones sensibles al tiempo real.
Simetría del ancho de banda
Muchos servicios residenciales o de bajo costo ofrecen ancho de banda asimétrico (más velocidad de descarga que de subida). Para una empresa que respalda datos en la nube, transmite video en vivo o aloja aplicaciones internas, el ancho de banda simétrico es indispensable: subir y bajar datos a la misma velocidad evita cuellos de botella en operaciones bidireccionales.
SLA (Service Level Agreement) y su letra pequeña
Un SLA no es solo un número de "disponibilidad". Hay que revisar:
- Porcentaje de uptime garantizado (99.9% permite hasta 8.76 horas de caída al año; 99.99% reduce esto a 52 minutos; 99.999%, conocido como "cinco nueves", limita la caída a poco más de 5 minutos anuales).
- Tiempo de respuesta ante incidentes (MTTR - Mean Time to Repair).
- Penalizaciones y créditos de servicio por incumplimiento.
- Métricas de jitter y packet loss garantizadas, no solo disponibilidad.
Redundancia y rutas alternas
La redundancia real implica múltiples rutas físicas, múltiples proveedores upstream y conmutación automática (failover) sin intervención manual. Preguntar "¿qué pasa si se corta la fibra principal?" y exigir una respuesta técnica concreta —no solo comercial— es clave.
SD-WAN y gestión inteligente del tráfico
Las arquitecturas SD-WAN (Software-Defined Wide Area Network) permiten priorizar tráfico crítico (voz, ERP, transacciones) sobre tráfico no crítico (navegación general, actualizaciones), seleccionar dinámicamente la mejor ruta disponible entre múltiples enlaces, y aplicar políticas de QoS (Quality of Service) de forma centralizada. Esto reduce el impacto de la degradación en un enlace individual porque el tráfico puede redirigirse automáticamente.
Casos de uso por industria
Manufactura
Las plantas industriales dependen cada vez más de sistemas MES (Manufacturing Execution Systems) y sensores IoT que reportan datos en tiempo real al ERP corporativo. Una latencia alta entre planta y nube retrasa la sincronización de órdenes de producción y genera discrepancias de inventario. Un enlace dedicado con SLA de 99.99% o superior, combinado con SD-WAN para priorizar tráfico de sensores sobre tráfico administrativo, resuelve este problema de raíz.
Retail y punto de venta
Las cadenas de retail con múltiples sucursales requieren que las terminales de pago (POS) se comuniquen sin interrupciones con el procesador de pagos. Una caída de red durante horas pico significa ventas perdidas y clientes insatisfechos. Aquí la redundancia con failover automático entre dos proveedores o dos rutas físicas es indispensable, especialmente en fechas de alto tráfico como El Buen Fin o Navidad.
Banca y servicios financieros
Las instituciones financieras operan bajo regulaciones estrictas de continuidad operativa. Cada transacción de cajero automático, banca en línea o transferencia SPEI depende de conectividad de baja latencia y alta disponibilidad entre sucursales, centros de datos y el banco central. Un SLA de 99.999% con monitoreo NOC 24/7 no es un lujo, es un requisito regulatorio implícito.
Logística y transporte
Los centros de distribución dependen de sistemas WMS (Warehouse Management System) sincronizados en tiempo real con flotas en movimiento. La latencia baja permite actualización instantánea de rutas y disponibilidad de inventario, mientras que las caídas prolongadas generan cuellos de botella en despacho.
Salud
Los hospitales que implementan telemedicina, expedientes clínicos electrónicos y equipos de diagnóstico conectados (como resonancias magnéticas que transmiten imágenes a especialistas remotos) requieren latencia ultra baja y cero tolerancia a caídas, ya que un fallo de conectividad puede impactar directamente la atención al paciente.
Gobierno y call centers
Las dependencias gubernamentales con trámites digitales y los call centers que gestionan miles de llamadas VoIP simultáneas necesitan ancho de banda simétrico robusto y jitter mínimo para evitar cortes de audio y pérdida de llamadas durante picos de demanda.
Errores comunes al elegir un proveedor de conectividad
Uno de los errores más frecuentes es contratar únicamente por precio y velocidad nominal, sin revisar el SLA de disponibilidad real ni las métricas de jitter y packet loss. Un enlace de 500 Mbps con 99% de disponibilidad puede ser peor para el negocio que uno de 300 Mbps con 99.99%.
Otro error es asumir que "redundancia" significa tener dos módems del mismo proveedor. Si ambos enlaces comparten la misma última milla física o el mismo proveedor upstream, un solo corte de fibra puede tumbar ambos simultáneamente. La redundancia real requiere diversidad de rutas y, cuando es posible, diversidad de proveedores.
También es común subestimar el tiempo de instalación en proyectos con fecha límite de apertura (una nueva sucursal, un centro de distribución). Proveedores que tardan semanas en activar un enlace dedicado pueden retrasar operaciones críticas de negocio.
Finalmente, muchas empresas no exigen visibilidad del NOC (Network Operations Center). Sin monitoreo proactivo 24/7, los problemas se detectan cuando el usuario final reporta la falla, no antes. Un buen proveedor debe poder mostrar métricas de latencia y disponibilidad en tiempo real, no solo prometerlas en el contrato.
Preguntas frecuentes
¿Cuál es la diferencia entre latencia y ancho de banda?
El ancho de banda mide cuántos datos pueden transmitirse por segundo (Mbps o Gbps); la latencia mide cuánto tarda cada paquete en llegar a su destino. Un enlace puede tener ancho de banda alto pero latencia elevada, lo cual sigue afectando negativamente aplicaciones en tiempo real como videollamadas o VoIP.
¿Qué SLA debería exigir mi empresa?
Depende de la criticidad de la operación. Para aplicaciones transaccionales o de misión crítica (banca, salud, retail), un SLA de 99.99% a 99.999% es recomendable. Para operaciones administrativas menos sensibles, 99.9% puede ser suficiente, siempre con penalizaciones claras por incumplimiento.
¿La fibra óptica siempre es mejor que el microondas?
En general sí, por su menor latencia y mayor inmunidad al clima, pero el microondas es útil como enlace de respaldo o en zonas donde la fibra no ha llegado aún. La estrategia ideal combina fibra como enlace primario y microondas o LTE como respaldo redundante.
¿Qué es el jitter y por qué afecta las videollamadas?
El jitter es la variación en el tiempo de llegada de los paquetes de datos. Cuando esta variación es alta, el audio y video se desincronizan, generando cortes y distorsión, incluso si la latencia promedio y el ancho de banda son adecuados.
¿Cuánto tiempo toma instalar un enlace dedicado empresarial?
Con proveedores que cuentan con backbone propio y presencia local extensa, la instalación puede completarse en 96 horas en zonas con cobertura de PoP cercana, frente a semanas en despliegues que dependen de infraestructura de terceros.
Cómo Smartnett ayuda
Smartnett aborda los problemas de latencia y caídas de red desde la arquitectura misma de su infraestructura, no como parches posteriores:
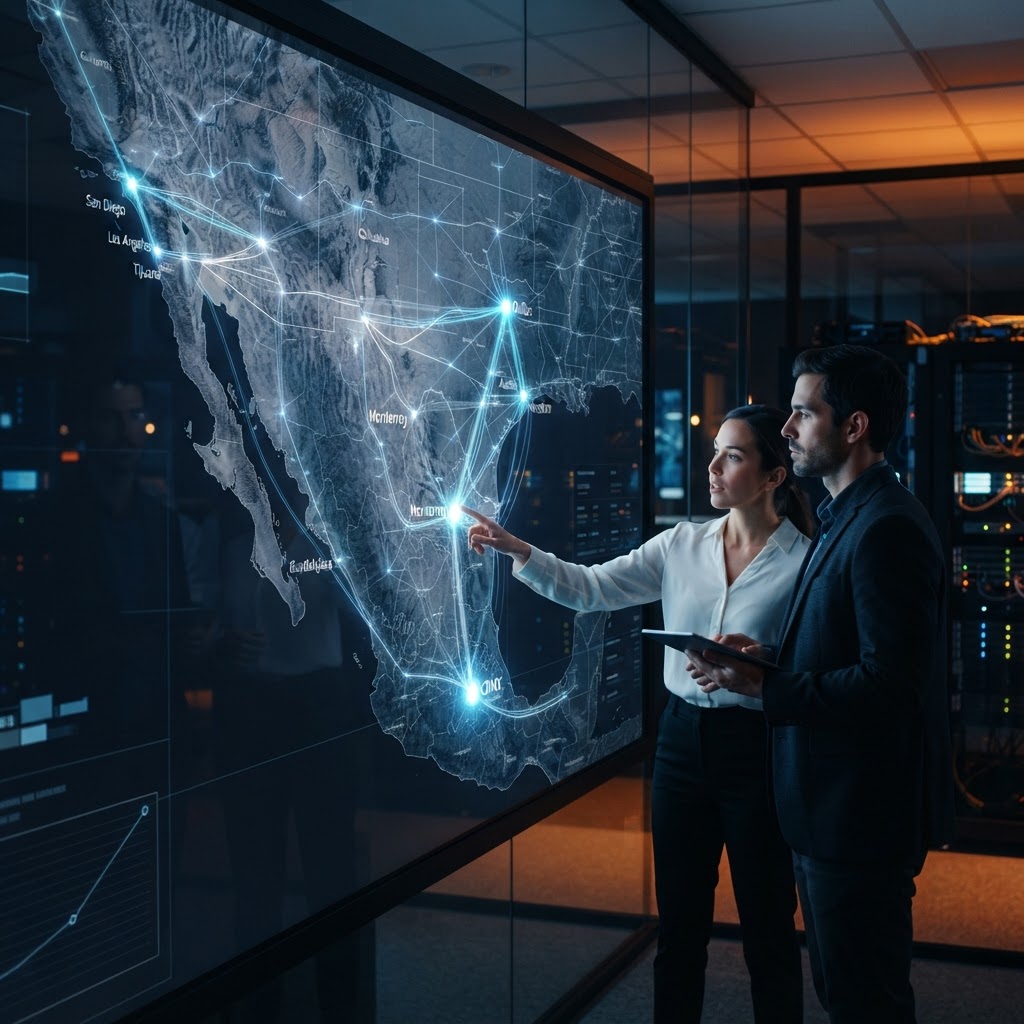
- Backbone propio de 53,100 km de fibra óptica con más de 220 PoPs (Puntos de Presencia) distribuidos estratégicamente, lo que reduce la distancia física entre el cliente y la red troncal, minimizando la latencia de propagación y evitando dependencia de terceros en tramos críticos.
- SLA de 99.999% de disponibilidad, respaldado por monitoreo activo desde un NOC operando 24/7/365, que detecta y responde a anomalías de red antes de que se conviertan en interrupciones perceptibles para el usuario final.
- Redundancia real de rutas dentro de su propia red troncal, permitiendo conmutación automática ante fallas en un segmento específico sin depender de un único proveedor upstream compartido.
- Instalación en 96 horas para proyectos empresariales, junto con planes de ancho de banda simétrico desde 300 Mbps hasta 10 Gbps y soporte para arquitecturas SD-WAN que priorizan tráfico crítico según las necesidades específicas de cada industria.
Conclusión
Minimizar la latencia y las caídas de red no depende de la suerte ni de comprar "más Mbps": depende de decisiones técnicas concretas sobre medio físico, arquitectura de red, SLA real y redundancia verificable. Un director de TI que entiende estos fundamentos puede exigir a sus proveedores las métricas correctas en lugar de conformarse con promesas comerciales genéricas.
Para avanzar de inmediato:
- Audita tu enlace actual midiendo latencia, jitter y packet loss durante al menos una semana en horarios pico.
- Exige a tu proveedor actual el desglose completo de su SLA, incluyendo penalizaciones específicas por incumplimiento.
- Evalúa si tu redundancia actual es real (rutas físicas distintas) o solo aparente (mismo proveedor, misma última milla).
- Prioriza ancho de banda simétrico si tu operación depende de subir datos a la nube constantemente (respaldos, ERP, video).
- Considera SD-WAN si operas múltiples sucursales y necesitas priorizar tráfico crítico sobre tráfico secundario de forma centralizada.
Escrito por
Ing. Roberto Mendoza Carrillo
Network Engineering — Smartnett
Ingeniero en Telecomunicaciones (UPIICSA-IPN). 12 años diseñando arquitecturas SD-WAN y enlaces dedicados para corporativos en México. Certificado Cisco CCNP y MikroTik MTCRE.